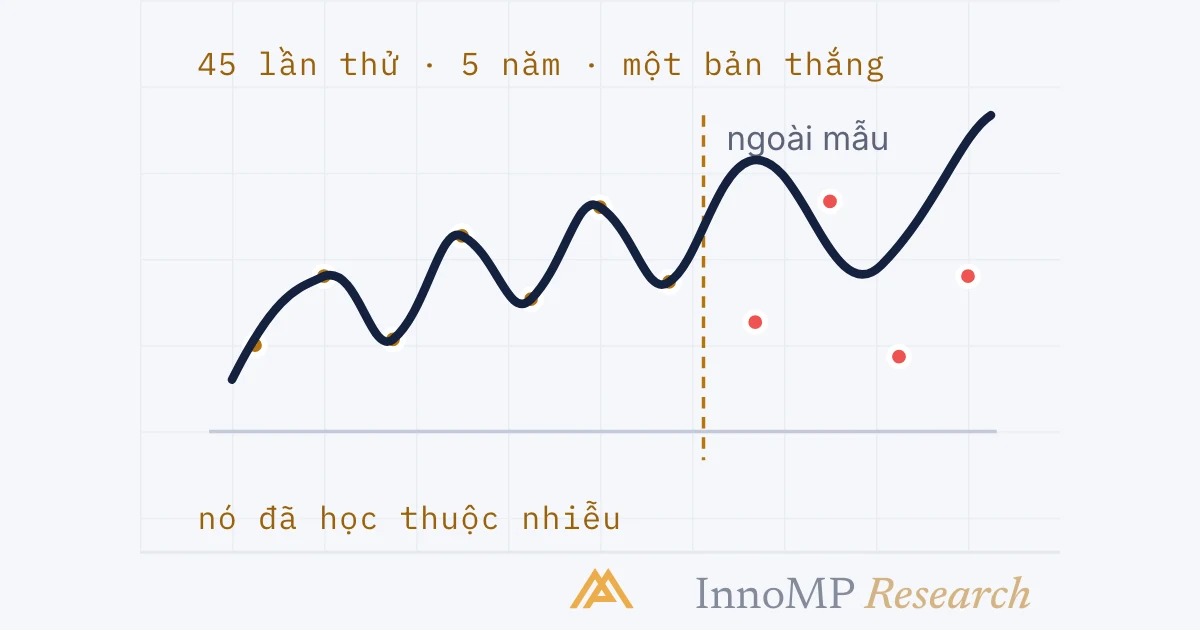
Overfitting là tinh chỉnh một quy tắc cho đến khi nó khớp với nhiễu của chính mẫu dùng để kiểm tra, nên kết quả của nó không duy trì được trên dữ liệu mới. Nó sinh ra từ số lần thử: trong mười cấu hình không có lợi thế thật, cấu hình tốt nhất được kỳ vọng có tỷ lệ Sharpe trong mẫu gần 1,6; với năm năm dữ liệu, 45 lần thử có thể tạo ra một cấu hình trông có kỹ năng trong mẫu nhưng trung bình bằng 0 ngoài mẫu. Cách phòng vệ: đếm mọi lần thử, để riêng dữ liệu, kiểm định walk-forward, chọn vùng phẳng thay vì đỉnh nhọn.
Overfitting là tinh chỉnh một quy tắc cho đến khi nó khớp với nhiễu của chính mẫu dùng để kiểm tra, khiến hồ sơ của nó không duy trì được trên dữ liệu mới. Nó sinh ra từ số lần thử, không phải từ một lần kiểm tra riêng lẻ nào — và số lần thử chính là phần bằng chứng gần như không bao giờ được ghi lại. Trong nhiều backtest, backtest đẹp nhất là cái có con số ít ý nghĩa nhất.
Phần 11 và 12 giả định chỉ có một hồ sơ, được ghi chép trung thực. Phần này nói về những hồ sơ không được giữ lại: các phiên bản của quy tắc đã được thử rồi bỏ đi trên đường đến phiên bản nằm trong sổ. Chúng thay đổi ý nghĩa của hồ sơ còn sống sót, và các công cụ để xử lý chúng còn lâu đời hơn cả nghề giao dịch.
Khớp tín hiệu, khớp nhiễu
Bất kỳ tập hợp giao dịch quá khứ nào cũng chứa hai thứ: điều lặp lại, và điều chỉ xảy ra một lần. Một quy tắc có đủ nhiều bộ phận điều chỉnh được có thể bị uốn để khớp cả hai.
Trong một setup, các bộ phận điều chỉnh được là tham số: bội số ATR của mức cắt lỗ, độ dài lookback, bộ lọc phiên, độ sâu pullback tối thiểu, điều kiện loại trừ theo ngày trong tuần được thêm vào sau một ngày thứ Sáu tồi tệ. Mỗi tham số là một núm vặn, và mỗi giá trị được thử trên cùng một dữ liệu là một cơ hội để khớp với một tình cờ. Overfitting — theo cách gọi cũ hơn là curve fitting — là điều setup đã làm khi hồ sơ của nó trên dữ liệu tinh chỉnh xuất sắc còn hồ sơ trên mọi dữ liệu khác thì bình thường hoặc tệ hơn. Nhà giao dịch làm điều đó hiếm khi nhận ra, vì nhìn từ bên trong, mỗi lần điều chỉnh đều trông như đang học.
Tốt nhất trong N không phải là tốt nhất
Cơ chế này không hề tinh vi, và một bài báo năm 2014 trên Notices of the American Mathematical Society của Bailey, Borwein, López de Prado và Zhu đã gắn con số cho nó. Giả sử một nhà nghiên cứu thử N cấu hình của một chiến lược, không cấu hình nào có lợi thế thật — tất cả đều có tỷ lệ Sharpe thật bằng 0. Cấu hình tốt nhất trong N, đo trên mẫu, sẽ không cho ra 0. Nó sẽ cho ra giá trị lớn nhất kỳ vọng của N kết quả ngẫu nhiên, và con số đó tăng theo N.
Tỷ lệ Sharpe là phiên bản tài chính của một tỷ số mà nhóm bài này đã dùng: lợi nhuận trung bình chia cho độ phân tán của lợi nhuận, quy về năm — tức kỳ vọng chia cho độ lệch chuẩn của nó, theo đơn vị của Phần 11. Ví dụ của bài báo là mười cấu hình, tất cả đều không có kỹ năng, mà cấu hình tốt nhất được kỳ vọng có tỷ lệ Sharpe trong mẫu là 1,57. Một nhà giao dịch thủ công không tính tỷ lệ Sharpe, nhưng logic chuyển sang nguyên vẹn: phiên bản tốt nhất trong mười phiên bản của một setup, được tinh chỉnh trên cùng một năm biểu đồ, có kỳ vọng bị thổi phồng bởi chính việc chọn, và thanh sai số của Phần 11 — tính như thể đó là phiên bản duy nhất — hẹp hơn thực tế một lượng phụ thuộc vào chín phiên bản đã bị vứt đi.
Đó là toàn bộ vấn đề trong một câu. Hồ sơ của bản thắng chưa phải là bằng chứng về bản thắng cho đến khi biết được số bản thua.
Độ dài backtest tối thiểu
Bài báo biến cùng phép tính đó thành một quy tắc kinh nghiệm gọi là độ dài backtest tối thiểu (minimum backtest length): số năm dữ liệu cần có để lần thử tốt nhất trong N lần không được kỳ vọng đạt một tỷ lệ Sharpe trong mẫu nhất định chỉ nhờ ngẫu nhiên.
Ví dụ của chính bài báo là hai trường hợp trong hình: năm năm dữ liệu chỉ chịu được khoảng bốn mươi lăm cấu hình độc lập trước khi một cấu hình không có kỹ năng được kỳ vọng trông như có tỷ lệ Sharpe bằng 1; hai năm chịu được khoảng bảy. Các tác giả cẩn thận nói rõ con số này không phải là gì. Nó giả định các lần thử độc lập với nhau, điều này khiến nó mang tính thận trọng — mười giá trị của cùng một bội số cắt lỗ không phải mười ý tưởng độc lập — và nó là điều kiện cần, không phải điều kiện đủ: một backtest vẫn có thể bị overfitting trên một mẫu dài hơn mức tối thiểu rất nhiều. Điều nó là: câu trả lời đầu tiên cho một câu hỏi mà hầu hết mọi người không bao giờ đặt ra với một hồ sơ — bao nhiêu lần thử đã tạo ra nó — và phàn nàn trung tâm của các tác giả là con số này gần như không bao giờ được công bố, trong các bài báo học thuật cũng như bởi bất kỳ ai bán một kết quả, khiến không thể đánh giá rủi ro overfitting chỉ từ kết quả.
Với một nhà giao dịch thủ công, số lần thử nhỏ và dữ liệu ngắn. Một năm biểu đồ bốn giờ trên hai cặp tiền, và một setup có bội số cắt lỗ, bộ lọc phiên và độ sâu pullback mỗi thứ được thử ở ba giá trị, là hai mươi bảy cấu hình trên một năm — đã vượt qua lằn ranh của bài báo. Hồ sơ của bản thắng có thể vẫn ổn. Chỉ là nó chưa phải bằng chứng.
Để riêng dữ liệu
Cách chữa lâu đời nhất là giữ một phần dữ liệu tránh xa khâu tinh chỉnh.
Kiểm định ngoài mẫu (out-of-sample test) là chạy một quy tắc một lần, không thay đổi, trên dữ liệu nó chưa từng được tinh chỉnh. Nếu hồ sơ ngoài mẫu giống hồ sơ trong mẫu — kỳ vọng cùng cỡ, khoảng tin cậy chồng lên nhau — quy tắc đã học được điều gì đó tồn tại vượt ra ngoài dữ liệu tinh chỉnh. Nếu hồ sơ sụp đổ, các con số trong mẫu chính là nhiễu. Toàn bộ kỷ luật nằm ở chữ một lần: dữ liệu để riêng bị tiêu hết ngay khoảnh khắc nó được nhìn vào, và mọi điều chỉnh thực hiện sau khi nhìn đều biến lần chạy tiếp theo thành trong mẫu theo định nghĩa. Bài báo cũng nêu giới hạn của phương pháp — dữ liệu để riêng không biết có bao nhiêu lần thử đã diễn ra trước nó, nên một quy tắc sống sót qua bước để riêng vẫn là bản tốt nhất trong N theo một nghĩa khác — nhưng như một bộ lọc đầu tiên, nó loại bỏ phần lớn những gì phần trước mô tả.
Forward test của cấp Trung cấp là cùng ý tưởng đó, chỉ khác là dữ liệu do lịch cung cấp thay vì kho lưu trữ: các giao dịch demo thực hiện theo thời gian thực không thể đã bị dùng để tinh chỉnh, vì lúc đó chúng chưa xảy ra.
Walk forward
Một lần chia chỉ tiêu dữ liệu một lần. Walk-forward tiêu nó lặp đi lặp lại và thu được một hồ sơ ngoài mẫu dài hơn từ cùng một lịch sử.
Kiểm định walk-forward (walk-forward test) là kiểm định ngoài mẫu lặp lại suốt lịch sử: tinh chỉnh trên khoảng đầu tiên, thử trên giai đoạn ngay sau đó, trượt cả hai về phía trước một đoạn bằng độ dài giai đoạn thử, rồi ghép các giai đoạn thử lại với nhau. Hồ sơ ghép lại có đúng thuộc tính quan trọng — không phần nào của nó từng bị dùng để tinh chỉnh — và đủ dài để có thanh sai số riêng. Nó còn tạo ra một thứ mà một lần chia đơn lẻ không có: chuỗi tham số được chọn ở mỗi khoảng. Nếu bội số cắt lỗ cho kết quả thử tốt nhất là 1,5 ở khoảng này, 2,5 ở khoảng sau và 1,2 ở khoảng thứ ba, quy tắc không có tham số ổn định, và việc tinh chỉnh lại nó ở mỗi khoảng chính là overfitting, chỉ là được làm theo lịch.
Vùng phẳng, không phải đỉnh nhọn
Tuyến phòng vệ cuối cùng là về cách chọn một tham số bên trong một khoảng, và nó hoàn toàn không cần dữ liệu để riêng.
Quét một tham số qua toàn bộ dải hợp lý của nó và vẽ kết quả theo tham số đó. Một quy tắc hiệu quả có một vùng phẳng: một dải giá trị cho kết quả tương tự nhau, vì đặc điểm thị trường mà quy tắc nắm bắt không nhạy với con số chính xác. Một quy tắc khớp với nhiễu có một đỉnh nhọn: một giá trị tốt hơn hẳn các giá trị lân cận, vì giá trị đó tình cờ bắt trúng những tình cờ của mẫu này. Đỉnh nhọn luôn là giá trị lớn nhất, và đó là lý do chọn giá trị lớn nhất là sai lầm. Hãy chọn một giá trị bên trong vùng phẳng — ở giữa vùng, không phải điểm tốt nhất trên đó — và quy tắc mất một chút trên dữ liệu tinh chỉnh nhưng giữ được phần lớn ở những nơi khác.
Điểm chính Lần thử tốt nhất trong N lần được kỳ vọng trông đẹp nhờ may rủi, và mức đẹp tăng theo N. Hãy đếm số lần thử và giữ con số đó cùng hồ sơ. Để riêng dữ liệu và chỉ dùng nó một lần. Kiểm định walk-forward và đọc cả chuỗi tham số lẫn hồ sơ ghép lại. Bên trong một khoảng, hãy chọn vùng phẳng, không chọn đỉnh nhọn.
Nhật ký lần thử
Mọi điều ở trên quy về một bổ sung cho nhật ký giao dịch đã xây dựng từ trước: một nhật ký các lần thử. Mọi cấu hình đã thử, dữ liệu dùng để thử, kết quả của nó, và lý do bị loại — kể cả những cấu hình chỉ được thử trong đầu suốt một buổi chiều rồi bỏ, vì luận điểm của bài báo là chúng cũng được tính. Nhật ký làm ba việc. Nó cho ra N, để con số của bản sống sót được đọc trong tương quan với số bản thua. Nó ghi lại các lần quét tham số, để sau này, khi mẫu dài hơn, có thể phân biệt đỉnh nhọn với vùng phẳng. Và nó khiến các lần điều chỉnh hiện ra đúng là điều chỉnh — tuyến phòng vệ duy nhất trước cảm giác, từ bên trong, rằng mỗi lần đều là đang học.
Nhận xét cuối cùng của bài báo là điều nên dùng để khép lại. Khi các lần thử không được đếm, một backtest đẹp không chỉ đơn thuần là không mang thông tin; trên dữ liệu có trí nhớ — nơi một giai đoạn đã được khớp có xu hướng bị theo sau bởi điều ngược lại — các tác giả cho thấy kỳ vọng ngoài mẫu của một quy tắc bị overfitting là âm. Họ viết rằng lời cảnh báo quen thuộc “hiệu quả trong quá khứ không cho biết kết quả tương lai” là quá lạc quan trong bối cảnh đó. Một hồ sơ được chọn ra không phải là một tín hiệu yếu. Nó có thể là một tín hiệu chỉ sai hướng.
Hồ sơ đứng ở đâu sau tất cả những điều này
Nhóm bài “Kiểm chứng lợi thế” đến đây là kết thúc. Một hồ sơ giờ mang ba thứ mà nó chưa mang ở cuối cấp Trung cấp: thanh sai số cho kỳ vọng, một phân phối quanh mức sụt giảm vốn (drawdown), và số lần thử đứng sau nó. Một setup có khoảng tin cậy vượt qua chi phí, có phần đuôi sụt giảm vốn đã được tính vào khối lượng, và có số lần thử nhỏ, được ghi lại, thì có một lợi thế theo nghĩa duy nhất mà cấp độ này dùng từ đó. Nhóm cuối cùng của cấp độ — Phần 14 đến 16 — lấy một setup đã vượt qua và biến nó thành thứ có thể vận hành: một bảng quyết định, quy tắc cảnh báo và thực thi, và một nhịp rà soát cùng tiêu chí để dừng nó.
Tiếp theo: Từ quy tắc đến bảng quyết định — mỗi trạng thái của thị trường có một cột, và những khoảng trống, mâu thuẫn mà văn xuôi che giấu lộ ra.
- Trong 10 cấu hình có tỷ lệ Sharpe thật bằng 0, cấu hình tốt nhất được kỳ vọng có tỷ lệ Sharpe trong mẫu là 1,57 (Bailey, Borwein, López de Prado và Zhu, 2014).
- Với 5 năm dữ liệu, không nên thử quá 45 cấu hình độc lập trước khi một cấu hình không có kỹ năng được kỳ vọng đạt tỷ lệ Sharpe trong mẫu bằng 1; với 2 năm, con số là 7.
- Số lần thử đứng sau một backtest gần như không bao giờ được công bố, nên không thể đánh giá rủi ro overfitting chỉ từ kết quả.
- Hiệu quả ngoài mẫu của một quy tắc bị overfitting được kỳ vọng quanh mức 0 nếu chuỗi dữ liệu không có trí nhớ, và âm nếu có.
- Kiểm định ngoài mẫu giữ lại phần dữ liệu mà quy tắc chưa từng được tinh chỉnh trên đó; kiểm định walk-forward lặp lại cách chia đó theo từng khoảng suốt lịch sử.