El sobreajuste (overfitting) es ajustar una regla hasta que encaja con el ruido de la muestra en la que se probó, de modo que su historial no se traslada a datos nuevos. Nace de las pruebas: entre diez configuraciones sin ventaja real, se espera que la mejor muestre un Sharpe cercano a 1,6 en la muestra, y con cinco años de datos, 45 pruebas pueden dar una que parezca hábil en la muestra y rinda cero de media fuera. Defensas: contar cada prueba, apartar datos, avanzar la prueba y preferir una meseta a un pico.
El sobreajuste (overfitting) es ajustar una regla hasta que encaja con el ruido de la muestra en la que se probó, de modo que su historial no se traslada a datos nuevos. Nace de las pruebas, no de una prueba concreta, y el número de pruebas es la parte de la evidencia que casi nunca se anota. El mejor backtest de muchos es aquel cuyas cifras significan menos.
Las partes 11 y 12 daban por hecho un solo historial, llevado con honestidad. Esta parte trata de los historiales que no se guardaron: las versiones de la regla probadas y descartadas por el camino hasta la que quedó en el cuaderno. Cambian lo que significa el historial superviviente, y las herramientas para tratarlas son más antiguas que el trading.
Ajustar la señal, ajustar el ruido
Cualquier conjunto de operaciones pasadas contiene dos cosas: lo que se repite y lo que ocurrió una sola vez. Una regla con suficientes piezas ajustables se puede doblar para que encaje con ambas.
En un setup, las piezas ajustables son los parámetros: el múltiplo del ATR en el stop, el período de referencia, el filtro de sesión, la profundidad mínima del retroceso, la exclusión de un día de la semana añadida tras un mal viernes. Cada uno es un mando, y cada valor probado sobre los mismos datos es una ocasión de encajar con un accidente. El sobreajuste (ajuste de curvas, en la expresión más antigua) es lo que le ha pasado al setup cuando su historial en los datos de ajuste es excelente y su historial en cualquier otra cosa es corriente o peor. El trader que lo hizo rara vez lo nota, porque desde dentro cada ajuste parecía aprendizaje.
La mejor de N no es la mejor
El mecanismo no es sutil, y un artículo de 2014 en las Notices of the American Mathematical Society, de Bailey, Borwein, López de Prado y Zhu, le puso cifras. Suponga que un investigador prueba N configuraciones de una estrategia y que ninguna tiene una ventaja real: todas tienen un ratio de Sharpe real de cero. La mejor de las N, medida sobre la muestra, no mostrará cero. Mostrará el máximo esperado de N resultados de azar, y esa cifra crece con N.
El ratio de Sharpe es la versión financiera de un cociente que este grupo ya ha usado: un rendimiento medio dividido por la dispersión de los rendimientos, anualizado; la esperanza matemática sobre su desviación típica, en los términos de la Parte 11. El ejemplo del artículo son diez configuraciones, todas sin habilidad, de las que se espera que la mejor muestre un ratio de Sharpe de 1,57 dentro de la muestra. Un trader discrecional no calcula ratios de Sharpe, pero la lógica se traslada sin cambios: la mejor de diez versiones de un setup, ajustadas sobre el mismo año de gráficos, tiene una esperanza matemática inflada por la elección, y las barras de error de la Parte 11 (calculadas como si fuera la única versión) son demasiado estrechas en una cantidad que depende de las nueve que se descartaron.
Ese es todo el problema en una frase. El historial de la ganadora no es evidencia sobre la ganadora hasta que se conoce el número de perdedoras.
Longitud mínima del backtest
El artículo convierte la misma aritmética en una regla práctica que llama longitud mínima del backtest (minimum backtest length): los años de datos necesarios para que no se espere que la mejor de N pruebas alcance por puro azar un ratio de Sharpe determinado dentro de la muestra.
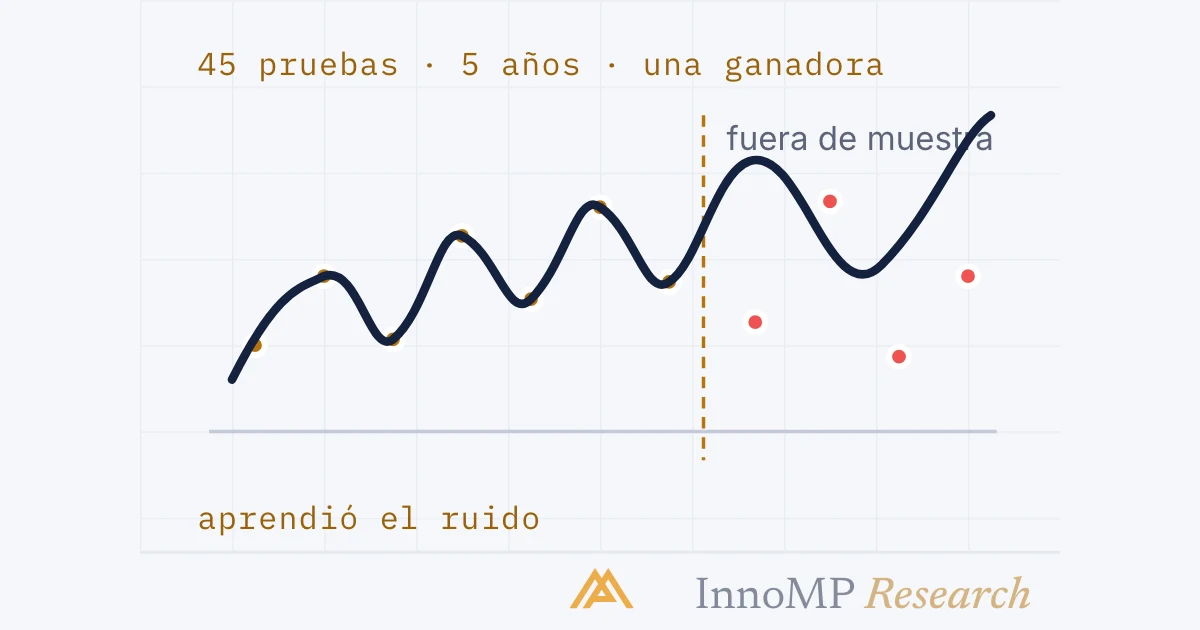
Los ejemplos del propio artículo son los dos de la figura: cinco años de datos admiten no más de unas cuarenta y cinco configuraciones independientes antes de que se espere que una sin habilidad aparente un ratio de Sharpe de 1; dos años admiten unas siete. Los autores tienen cuidado de decir lo que la cifra no es. Supone que las pruebas son independientes, lo que la hace conservadora (diez valores del mismo múltiplo del stop no son diez ideas independientes), y es una condición necesaria, no suficiente: un backtest puede estar sobreajustado en una muestra mucho más larga que la mínima. Lo que sí es: una primera respuesta a una pregunta que casi nadie le hace a un historial, cuántas pruebas lo produjeron. La queja central de los autores es que esa cifra casi nunca se publica, ni en los artículos académicos ni por parte de quien vende un resultado, lo que hace imposible evaluar el riesgo de sobreajuste solo a partir del resultado.
Para un trader discrecional, la cuenta es pequeña y los datos son cortos. Un año de gráficos de cuatro horas en dos pares, y un setup cuyo múltiplo del stop, filtro de sesión y profundidad del retroceso se probaron cada uno con tres valores, son veintisiete configuraciones sobre un año: ya por encima de la línea del artículo. El historial de la ganadora puede seguir siendo bueno. Simplemente, todavía no es evidencia.
Apartar datos
El remedio más antiguo es mantener una parte de los datos lejos del ajuste.
Una prueba fuera de la muestra (out-of-sample test) es una regla ejecutada una vez, sin cambios, sobre datos con los que nunca se ajustó. Si su historial fuera de la muestra se parece al de dentro (una esperanza matemática del mismo orden, un intervalo que se solapa), la regla aprendió algo que persistió más allá de los datos de ajuste. Si el historial se hunde, las cifras dentro de la muestra eran el ruido. Toda la disciplina está en las palabras una vez: los datos apartados se gastan en el momento en que se miran, y cualquier ajuste hecho después de mirar convierte por definición la siguiente ejecución en una prueba dentro de la muestra. El artículo señala también el límite del método (un conjunto apartado no sabe cuántas pruebas lo precedieron, así que una regla que lo superó sigue siendo la mejor de N en otro sentido), pero como primer filtro elimina la mayor parte de lo que describía la sección anterior.
El forward test del nivel Intermedio es la misma idea, con los datos aportados por el calendario y no por el archivo: las operaciones demo tomadas en tiempo real no pueden haberse usado para ajustar, porque todavía no habían ocurrido.
Avanzar la prueba (walk-forward)
Una sola división gasta los datos una vez. Avanzar la prueba los gasta repetidamente y obtiene un historial fuera de la muestra más largo con la misma historia.
Una prueba walk-forward (de avance progresivo) es una prueba fuera de la muestra repetida a lo largo del historial: ajustar en la primera ventana, probar en el período siguiente, desplazar ambos hacia delante la longitud del período de prueba y unir los períodos de prueba. El historial unido tiene la propiedad que importa (ninguna parte de él se usó para ajustar) y es lo bastante largo como para tener sus propias barras de error. Además produce algo que una sola división no da: la secuencia de parámetros elegidos en cada ventana. Si el múltiplo del stop que mejor salió es 1,5 en una ventana, 2,5 en la siguiente y 1,2 en la tercera, la regla no tiene un parámetro estable, y reajustarla en cada ventana es el sobreajuste, hecho según un calendario.
Meseta, no pico
La última defensa trata de cómo se elige un parámetro dentro de una ventana, y no necesita ningún dato apartado.
Recorra un parámetro a lo largo de su rango plausible y dibuje el resultado frente a él. Una regla que funciona tiene una meseta: un tramo de valores en el que el resultado es parecido, porque el rasgo del mercado que capta la regla no es sensible a la cifra exacta. Una regla ajustada al ruido tiene un pico: un valor mucho mejor que sus vecinos, porque ese valor dio la casualidad de atrapar los accidentes de esta muestra. El pico es siempre el máximo, y por eso elegir el máximo es el error. Elija un valor dentro de la meseta (en su centro, no en su mejor punto), y la regla pierde un poco en los datos de ajuste y conserva la mayor parte en todo lo demás.
Idea clave Se espera que la mejor de N pruebas se vea bien por azar, y cuánto de bien crece con N. Cuente las pruebas y guarde la cuenta junto al historial. Aparte datos y gástelos una sola vez. Avance la prueba y lea la secuencia de parámetros además del historial unido. Dentro de una ventana, elija la meseta, no el pico.
El registro de pruebas
Todo lo anterior se reduce a un añadido al diario que construyó el curso de Psicología del trading: un registro de pruebas. Cada configuración probada, los datos sobre los que se probó, su resultado y por qué se descartó, incluidas las que solo se probaron de cabeza durante una tarde y se abandonaron, porque lo que sostiene el artículo es que esas también cuentan. El registro hace tres cosas. Da N, para que las cifras de la superviviente puedan leerse frente al número de perdedoras. Guarda los barridos de parámetros, para que más adelante, cuando la muestra sea más larga, se pueda distinguir un pico de una meseta. Y hace visibles los ajustes como ajustes, que es la única defensa contra la sensación, desde dentro, de que cada uno era aprendizaje.
La última observación del artículo es la que sirve para cerrar. Cuando no se cuentan las pruebas, un buen backtest no es simplemente poco informativo: en datos con memoria (donde a un período al que se ajustó la regla tiende a seguirle su contrario), los autores muestran que la esperanza fuera de la muestra de una regla sobreajustada es negativa. La advertencia habitual de que los resultados pasados no indican resultados futuros, escriben, es demasiado optimista en ese contexto. Un historial elegido no es una señal débil. Puede ser una señal que apunta en la dirección equivocada.
Dónde deja esto al historial
El grupo termina aquí. Un historial lleva ahora tres cosas que no llevaba al final del nivel Intermedio: barras de error sobre su esperanza matemática, una distribución alrededor de su drawdown y la cuenta de las pruebas que hay detrás. Un setup cuyo intervalo supera los costes, cuya cola de drawdown está prevista en el tamaño y cuyo número de pruebas es pequeño y está anotado tiene una ventaja en el único sentido en que este nivel usa la palabra. El último grupo del nivel, las Partes 14 a 16, toma un setup que ha superado las pruebas y lo convierte en algo que se puede ejecutar: una tabla de decisión, reglas de alerta y de ejecución y un calendario de revisión con los criterios para desactivarlo.
Siguiente: De las reglas a una tabla de decisión. Cada estado del mercado recibe una columna, y salen a la luz los huecos y las contradicciones que la prosa ocultaba.
- Entre 10 configuraciones cuyo ratio de Sharpe real es cero, se espera que la mejor muestre un ratio de Sharpe de 1,57 dentro de la muestra (Bailey, Borwein, López de Prado y Zhu, 2014).
- Con 5 años de datos no deberían probarse más de 45 configuraciones independientes antes de que se espere que una sin habilidad alcance un ratio de Sharpe de 1 dentro de la muestra; con 2 años, la cifra es 7.
- El número de pruebas que hay detrás de un backtest casi nunca se publica, lo que hace imposible evaluar su riesgo de sobreajuste solo a partir del resultado.
- Se espera que el rendimiento fuera de la muestra de una regla sobreajustada ronde cero si la serie no tiene memoria, y que sea negativo si la tiene.
- Una prueba fuera de la muestra aparta datos con los que la regla nunca se ajustó; una prueba walk-forward repite esa división ventana a ventana a lo largo del historial.