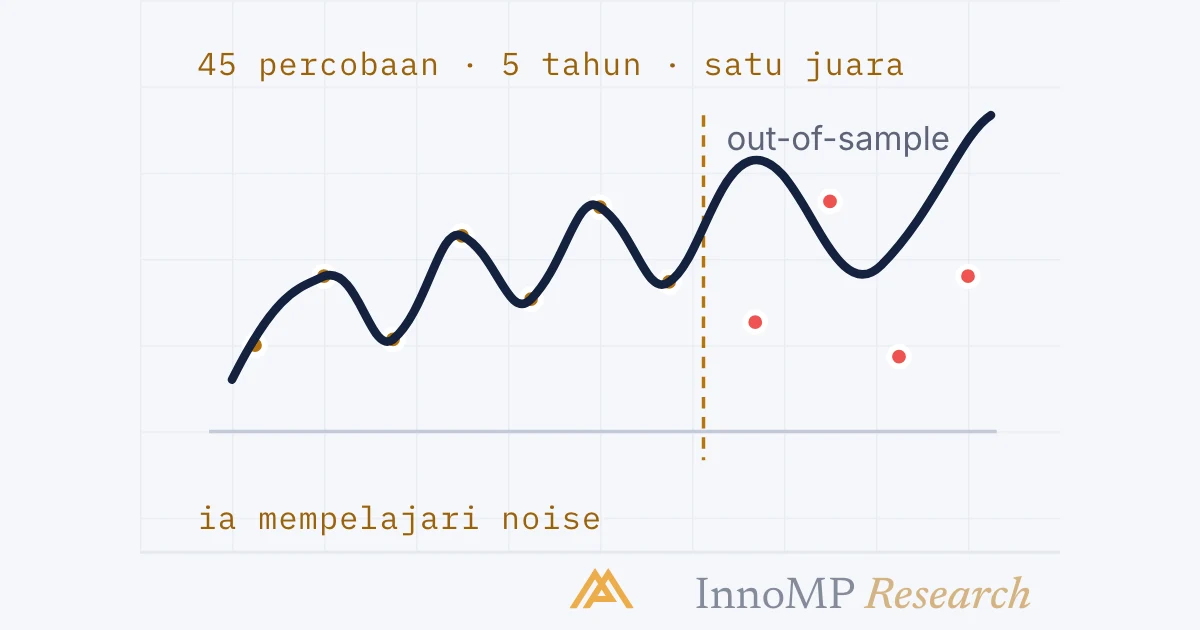
Overfitting adalah menyetel aturan sampai cocok dengan noise sampel ujinya, sehingga catatannya tidak terbawa ke data baru. Penyebabnya percobaan: dari sepuluh konfigurasi tanpa edge nyata, yang terbaik diperkirakan menunjukkan Sharpe ratio in-sample sekitar 1,6, dan dengan data lima tahun, 45 percobaan bisa menghasilkan satu yang tampak ahli in-sample dan rata-rata nol di luarnya. Pertahanannya: catat setiap percobaan, sisihkan data yang tak pernah dilihat aturan, uji walk-forward, dan pilih plateau, bukan puncak.
Overfitting adalah menyetel aturan sampai cocok dengan noise sampel tempat aturan itu diuji, sehingga catatannya tidak terbawa ke data baru. Penyebabnya adalah percobaan, bukan satu tes tertentu — dan jumlah percobaan adalah bagian bukti yang hampir tidak pernah ditulis. Backtest terbaik dari sekian banyak adalah backtest yang angkanya paling sedikit berarti.
Bagian 11 dan 12 mengasumsikan satu catatan yang disimpan dengan jujur. Bagian ini membahas catatan yang tidak disimpan: versi-versi aturan yang dicoba lalu dibuang dalam perjalanan menuju versi yang ada di buku catatan. Versi-versi itu mengubah arti catatan yang tersisa, dan alat untuk menanganinya lebih tua daripada trading.
Cocok dengan sinyal, cocok dengan noise
Setiap kumpulan trade masa lalu berisi dua hal: apa pun yang berulang, dan apa pun yang terjadi sekali saja. Aturan dengan cukup banyak bagian yang bisa disetel dapat dibengkokkan agar cocok dengan keduanya.
Dalam sebuah setup, bagian yang bisa disetel adalah parameternya: kelipatan ATR untuk stop, lookback, filter sesi, kedalaman pullback minimum, pengecualian hari tertentu yang ditambahkan setelah satu hari Jumat yang buruk. Masing-masing adalah sebuah kenop, dan setiap nilai yang dicoba pada data yang sama adalah satu peluang untuk mencocokkan sebuah kebetulan. Overfitting — curve fitting, dalam istilah lamanya — adalah apa yang telah terjadi pada setup ketika catatannya pada data penyetelan sangat bagus dan catatannya pada data lain biasa saja atau lebih buruk. Trader yang melakukannya jarang menyadari, karena dari dalam, setiap penyesuaian terasa seperti belajar.
Yang terbaik dari N bukanlah yang terbaik
Mekanismenya tidak rumit, dan sebuah makalah tahun 2014 di Notices of the American Mathematical Society oleh Bailey, Borwein, López de Prado, dan Zhu memberinya angka. Misalkan seorang peneliti mencoba N konfigurasi sebuah strategi, dan tidak satu pun punya edge nyata — semuanya punya Sharpe ratio sebenarnya nol. Yang terbaik dari N itu, diukur pada sampel, tidak akan menunjukkan nol. Ia akan menunjukkan perkiraan nilai maksimum dari N hasil kebetulan, dan angka itu naik seiring N.
Sharpe ratio adalah versi dunia keuangan dari rasio yang sudah dipakai kelompok ini: rata-rata return dibagi sebaran return, disetahunkan — expectancy dibagi standar deviasinya, dalam satuan Bagian 11. Contoh dalam makalah itu adalah sepuluh konfigurasi, semuanya tanpa keahlian, yang terbaiknya diperkirakan menunjukkan Sharpe ratio in-sample 1,57. Trader diskresioner tidak menghitung Sharpe ratio, tetapi logikanya berlaku tanpa perubahan: yang terbaik dari sepuluh versi sebuah setup, yang disetel pada grafik tahun yang sama, punya expectancy yang menggelembung karena dipilih, dan error bar dari Bagian 11 — yang dihitung seolah itu satu-satunya versi — terlalu sempit sebesar jumlah yang bergantung pada sembilan versi yang dibuang.
Itulah seluruh masalahnya dalam satu kalimat. Catatan sang pemenang belum menjadi bukti tentang sang pemenang sampai jumlah yang kalah diketahui.
Minimum backtest length
Makalah itu mengubah aritmetika yang sama menjadi patokan praktis yang disebutnya minimum backtest length: jumlah tahun data yang dibutuhkan agar yang terbaik dari N percobaan tidak diperkirakan mencapai Sharpe ratio in-sample tertentu hanya karena kebetulan.
Contoh dari makalah itu sendiri adalah dua yang ada di gambar: data lima tahun menopang tidak lebih dari sekitar empat puluh lima konfigurasi independen sebelum satu yang tanpa keahlian diperkirakan tampak seperti Sharpe ratio 1; data dua tahun menopang sekitar tujuh. Para penulis berhati-hati menyebut apa yang bukan arti angka itu. Angka itu mengasumsikan percobaannya independen, sehingga sifatnya konservatif — sepuluh nilai untuk kelipatan stop yang sama bukanlah sepuluh ide yang independen — dan ia syarat perlu, bukan syarat cukup: sebuah backtest bisa overfit pada sampel yang jauh lebih panjang dari batas minimum itu. Yang menjadi artinya adalah jawaban pertama atas pertanyaan yang jarang diajukan orang tentang sebuah catatan — berapa percobaan yang menghasilkannya — dan keluhan utama para penulis adalah bahwa angka itu hampir tidak pernah dilaporkan, baik dalam makalah akademis maupun oleh siapa pun yang menjual sebuah hasil, sehingga risiko overfitting mustahil dinilai dari hasilnya saja.
Bagi trader diskresioner, hitungannya kecil dan datanya pendek. Grafik empat jam setahun pada dua pair, dan setup yang kelipatan stop, filter sesi, dan kedalaman pullback-nya masing-masing dicoba pada tiga nilai, adalah dua puluh tujuh konfigurasi pada data satu tahun — sudah melewati garis makalah itu. Catatan sang pemenang mungkin tetap baik. Hanya saja, catatan itu belum menjadi bukti.
Sisihkan sebagian data
Obat tertua adalah menjauhkan sebagian data dari penyetelan.
Out-of-sample test adalah aturan yang dijalankan sekali, tanpa diubah, pada data yang tidak pernah dipakai untuk menyetelnya. Jika catatan out-of-sample-nya mirip catatan in-sample-nya — expectancy dengan orde yang sama, interval yang tumpang-tindih — aturan itu mempelajari sesuatu yang bertahan melewati data penyetelan. Jika catatannya runtuh, angka in-sample tadi adalah noise. Disiplinnya sepenuhnya ada pada kata sekali: data yang disisihkan habis terpakai begitu ia dilihat, dan penyesuaian apa pun yang dibuat setelah melihatnya menjadikan pengujian berikutnya in-sample menurut definisi. Makalah itu juga mencatat batas metode ini — data yang disisihkan tidak tahu berapa percobaan yang mendahuluinya, sehingga aturan yang lolos uji itu tetap saja yang terbaik dari N dalam arti yang lain — tetapi sebagai saringan pertama, cara ini menyingkirkan sebagian besar dari apa yang diuraikan bagian sebelumnya.
Forward test di tingkat Menengah adalah gagasan yang sama dengan data yang disediakan kalender alih-alih arsip: trade demo yang diambil secara real time tidak mungkin sudah dipakai untuk menyetel, karena trade itu belum terjadi.
Walk forward
Satu pembagian menghabiskan data sekali. Walk forward menghabiskannya berulang kali dan menghasilkan catatan out-of-sample yang lebih panjang dari sejarah data yang sama.
Walk-forward test adalah out-of-sample test yang diulang sepanjang sejarah data: setel pada jendela pertama, uji pada periode sesudahnya, geser keduanya ke depan sepanjang periode uji, lalu sambungkan periode-periode uji itu. Catatan sambungan ini punya sifat yang penting — tidak ada bagiannya yang dipakai untuk menyetel — dan cukup panjang untuk punya error bar sendiri. Tes ini juga menghasilkan sesuatu yang tidak dihasilkan satu pembagian: urutan parameter yang dipilih di setiap jendela. Jika kelipatan stop yang hasil ujinya terbaik adalah 1,5 di satu jendela, 2,5 di jendela berikutnya, dan 1,2 di jendela ketiga, aturan itu tidak punya parameter yang stabil, dan menyetelnya ulang di setiap jendela itulah overfitting-nya, dilakukan sesuai jadwal.
Plateau, bukan puncak
Pertahanan terakhir menyangkut cara memilih parameter di dalam satu jendela, dan sama sekali tidak memerlukan data yang disisihkan.
Sapu sebuah parameter di sepanjang rentang wajarnya dan gambarkan hasilnya terhadap parameter itu. Aturan yang berhasil punya plateau: serangkaian nilai yang hasilnya mirip, karena ciri pasar yang ditangkap aturan itu tidak peka terhadap angka persisnya. Aturan yang cocok dengan noise punya puncak: satu nilai yang jauh lebih baik daripada nilai-nilai di sekitarnya, karena nilai itu kebetulan menangkap kebetulan-kebetulan sampel ini. Puncak selalu merupakan nilai maksimum, itulah sebabnya memilih nilai maksimum adalah kesalahannya. Pilih nilai di dalam plateau — di tengahnya, bukan titik terbaik di atasnya — dan aturan itu kehilangan sedikit di data penyetelan dan mempertahankan sebagian besarnya di tempat lain.
Poin penting Yang terbaik dari N percobaan diperkirakan tampak bagus karena kebetulan, dan seberapa bagus naik seiring N. Hitung percobaannya dan simpan hitungannya bersama catatan. Sisihkan sebagian data dan pakai sekali saja. Jalankan tes secara walk-forward dan baca urutan parameternya, bukan hanya catatan sambungannya. Di dalam satu jendela, pilih plateau, bukan puncak.
Log percobaan
Semua hal di atas bermuara pada satu tambahan untuk jurnal yang dibangun di kursus Psikologi Trading: log percobaan. Setiap konfigurasi yang dicoba, data tempat ia dicoba, hasilnya, dan alasan ia dibuang — termasuk yang hanya dicoba di kepala selama satu sore lalu ditinggalkan, karena inti makalah itu adalah bahwa percobaan semacam itu ikut dihitung. Log ini melakukan tiga hal. Ia memberi N, sehingga angka yang bertahan bisa dibaca terhadap jumlah yang kalah. Ia mencatat sapuan parameter, sehingga puncak bisa dibedakan dari plateau nanti, ketika sampelnya lebih panjang. Dan ia membuat penyesuaian terlihat sebagai penyesuaian, satu-satunya pertahanan terhadap perasaan, dari dalam, bahwa setiap penyesuaian adalah belajar.
Pengamatan terakhir makalah itu layak menjadi penutup. Ketika percobaan tidak dihitung, backtest yang bagus bukan sekadar tidak informatif; pada data yang punya memori — ketika periode yang dicocokkan cenderung diikuti oleh kebalikannya — para penulis menunjukkan bahwa perkiraan out-of-sample aturan yang overfit bernilai negatif. Peringatan lazim bahwa kinerja masa lalu tidak menunjukkan hasil di masa depan, tulis mereka, terlalu optimistis dalam keadaan itu. Catatan yang dipilih bukanlah sinyal yang lemah. Ia bisa menjadi sinyal yang menunjuk ke arah yang salah.
Posisi catatan sekarang
Kelompok ini selesai. Sebuah catatan kini membawa tiga hal yang belum dibawanya di akhir tingkat Menengah: error bar pada expectancy-nya, distribusi di sekitar drawdown-nya, dan jumlah percobaan di baliknya. Setup yang intervalnya melampaui biaya, yang ekor drawdown-nya sudah diperhitungkan dalam ukuran posisi, dan yang jumlah percobaannya kecil serta tertulis, punya edge dalam satu-satunya arti kata itu yang dipakai tingkat ini. Kelompok terakhir tingkat ini — Bagian 14 sampai 16 — mengambil setup yang sudah lolos dan mengubahnya menjadi sesuatu yang bisa dijalankan: sebuah tabel keputusan, aturan alert dan eksekusi, serta jadwal tinjauan dengan kriteria untuk menghentikannya.
Berikutnya: Dari aturan ke tabel keputusan — setiap keadaan pasar mendapat satu kolom, dan celah serta kontradiksi yang disembunyikan uraian kalimat pun terlihat.
- Di antara 10 konfigurasi yang Sharpe ratio sebenarnya nol, yang terbaik diperkirakan menunjukkan Sharpe ratio in-sample 1,57 (Bailey, Borwein, López de Prado, dan Zhu, 2014).
- Dengan data 5 tahun, tidak lebih dari 45 konfigurasi independen boleh dicoba sebelum satu konfigurasi tanpa keahlian diperkirakan mencapai Sharpe ratio in-sample 1; dengan data 2 tahun, angkanya 7.
- Jumlah percobaan di balik sebuah backtest hampir tidak pernah dilaporkan, sehingga risiko overfitting-nya mustahil dinilai dari hasilnya saja.
- Kinerja out-of-sample aturan yang overfit diperkirakan sekitar nol jika deretnya tidak punya memori, dan negatif jika punya.
- Out-of-sample test menyisihkan data yang tidak pernah dipakai untuk menyetel aturan; walk-forward test mengulang pembagian itu jendela demi jendela sepanjang sejarah data.