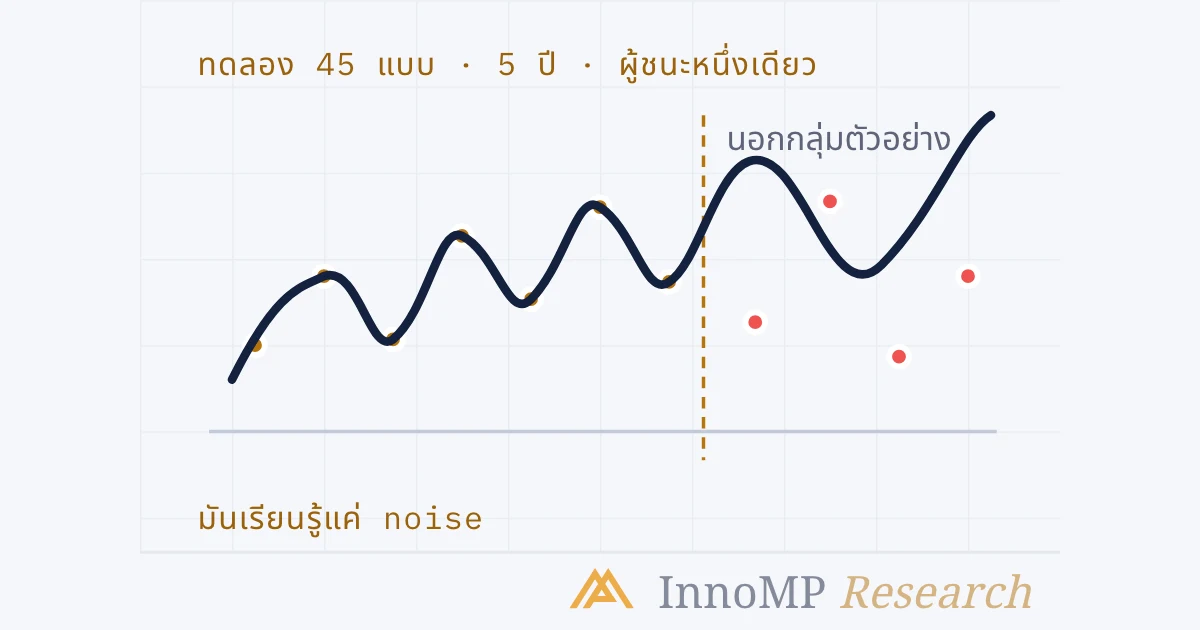
Overfitting คือการปรับแต่งกฎจนเข้ากับ noise ของกลุ่มตัวอย่างที่ใช้ทดสอบ จนผลไม่ส่งต่อไปยังข้อมูลใหม่ ต้นเหตุคือการทดลอง: ในการตั้งค่า 10 แบบที่ไม่มีความได้เปรียบจริงเลย แบบที่ดีที่สุดคาดว่าจะแสดง Sharpe ratio ในกลุ่มตัวอย่างราว 1.6 และด้วยข้อมูล 5 ปี การทดลอง 45 ครั้งก็พอจะได้แบบที่ดูมีฝีมือในกลุ่มตัวอย่างแต่เฉลี่ยเป็นศูนย์นอกกลุ่มตัวอย่าง วิธีป้องกันคือนับทุกการทดลอง กันข้อมูลที่กฎไม่เคยเห็นไว้ ทดสอบแบบเดินหน้า (walk-forward) และเลือกช่วงที่ราบของพารามิเตอร์แทนจุดยอด
Overfitting คือการปรับแต่งกฎจนเข้ากับ noise ของกลุ่มตัวอย่างที่ใช้ทดสอบ จนบันทึกผลไม่ส่งต่อไปยังข้อมูลใหม่ ต้นเหตุคือการทดลอง ไม่ใช่การทดสอบครั้งใดครั้งหนึ่ง — และจำนวนการทดลองคือส่วนของหลักฐานที่แทบไม่เคยถูกจดไว้ แบ็กเทสต์ที่ดีที่สุดในหลาย ๆ ชุด คือชุดที่ตัวเลขมีความหมายน้อยที่สุด
ตอนที่ 11 และ 12 ตั้งสมมติฐานว่ามีบันทึกชุดเดียวที่เก็บอย่างซื่อตรง ตอนนี้ว่าด้วยบันทึกที่ไม่ได้ถูกเก็บไว้: กฎเวอร์ชันต่าง ๆ ที่ลองแล้วทิ้งไประหว่างทางสู่เวอร์ชันที่อยู่ในสมุด มันเปลี่ยนความหมายของบันทึกที่เหลืออยู่ และเครื่องมือที่ใช้รับมือกับมันเก่าแก่กว่าการเทรดเสียอีก
เข้ากับสัญญาณ เข้ากับ noise
ชุดเทรดในอดีตชุดใดก็ตามมีสองอย่างอยู่ในนั้น: สิ่งที่เกิดซ้ำ และสิ่งที่เกิดขึ้นเพียงครั้งเดียว กฎที่มีส่วนให้ปรับได้มากพอ สามารถดัดให้เข้ากับทั้งสองอย่างได้
ในเซ็ตอัป ส่วนที่ปรับได้คือพารามิเตอร์: ตัวคูณ ATR ของ Stop Loss ช่วงย้อนหลัง ตัวกรองเซสชัน ความลึกขั้นต่ำของการย่อตัว (pullback) การตัดวันในสัปดาห์ที่เพิ่มเข้ามาหลังวันศุกร์ที่แย่ แต่ละอย่างคือปุ่มปรับ และทุกค่าที่ลองบนข้อมูลชุดเดิมคือโอกาสที่จะไปตรงกับความบังเอิญ Overfitting — ที่สมัยก่อนเรียกว่า curve fitting — คือสิ่งที่เซ็ตอัปได้ทำไปแล้ว เมื่อบันทึกบนข้อมูลที่ใช้ปรับแต่งยอดเยี่ยม แต่บันทึกบนข้อมูลอื่นธรรมดาหรือแย่กว่า เทรดเดอร์ที่ทำเช่นนั้นแทบไม่รู้ตัว เพราะเมื่อมองจากข้างใน การปรับทุกครั้งดูเหมือนการเรียนรู้
ดีที่สุดใน N แบบ ไม่ใช่ดีที่สุดจริง
กลไกนี้ไม่ได้ซับซ้อน และบทความปี 2014 ใน Notices of the American Mathematical Society โดย Bailey, Borwein, López de Prado และ Zhu ได้ใส่ตัวเลขให้มัน สมมติว่านักวิจัยคนหนึ่งลองกลยุทธ์ N แบบ โดยไม่มีแบบใดมีความได้เปรียบจริงเลย — ทุกแบบมี Sharpe ratio จริงเท่ากับศูนย์ แบบที่ดีที่สุดใน N แบบ เมื่อวัดบนกลุ่มตัวอย่าง จะไม่แสดงศูนย์ มันจะแสดงค่าสูงสุดที่คาดได้ของผลจากความบังเอิญ N ครั้ง และตัวเลขนั้นเพิ่มขึ้นตาม N
Sharpe ratio คืออัตราส่วนแบบเดียวกับที่กลุ่มนี้ใช้มาแล้วในภาษาการเงิน: ผลตอบแทนเฉลี่ยหารด้วยการกระจายของผลตอบแทน คิดเป็นรายปี — ค่าคาดหวังหารด้วยส่วนเบี่ยงเบนมาตรฐานของมัน ในหน่วยของตอนที่ 11 ตัวอย่างในบทความคือการตั้งค่าสิบแบบที่ไม่มีฝีมือเลยทั้งหมด ซึ่งแบบที่ดีที่สุดคาดว่าจะแสดง Sharpe ratio ในกลุ่มตัวอย่าง 1.57 เทรดเดอร์ที่ใช้ดุลยพินิจไม่ได้คำนวณ Sharpe ratio แต่ตรรกะนี้ใช้ได้โดยไม่ต้องเปลี่ยนอะไร: เซ็ตอัปเวอร์ชันที่ดีที่สุดในสิบเวอร์ชัน ที่ปรับแต่งบนกราฟปีเดียวกัน มีค่าคาดหวังที่สูงเกินจริงเพราะการคัดเลือก และแถบความคลาดเคลื่อน (error bars) จากตอนที่ 11 — ที่คำนวณราวกับว่ามันเป็นเวอร์ชันเดียว — แคบเกินไปในปริมาณที่ขึ้นอยู่กับอีกเก้าเวอร์ชันที่ถูกทิ้งไป
นั่นคือปัญหาทั้งหมดในประโยคเดียว บันทึกของผู้ชนะยังไม่ใช่หลักฐานเกี่ยวกับผู้ชนะ จนกว่าจะรู้จำนวนผู้แพ้
ความยาวแบ็กเทสต์ขั้นต่ำ
บทความนำเลขคณิตชุดเดียวกันมาทำเป็นหลักง่าย ๆ ที่เรียกว่า ความยาวแบ็กเทสต์ขั้นต่ำ (minimum backtest length): จำนวนปีของข้อมูลที่ต้องใช้ เพื่อไม่ให้คาดได้ว่าแบบที่ดีที่สุดใน N การทดลองจะทำ Sharpe ratio ในกลุ่มตัวอย่างได้ถึงระดับที่กำหนดเพียงเพราะความบังเอิญ
ตัวอย่างของบทความเองคือสองกรณีในภาพ: ข้อมูลห้าปีรองรับการตั้งค่าที่เป็นอิสระต่อกันได้ไม่เกินราวสี่สิบห้าแบบ ก่อนที่จะคาดได้ว่าแบบที่ไม่มีฝีมือจะดูเหมือนมี Sharpe ratio เท่ากับ 1 ข้อมูลสองปีรองรับได้ราวเจ็ดแบบ ผู้เขียนระวังที่จะบอกว่าตัวเลขนี้ไม่ใช่อะไร มันสมมติว่าการทดลองเป็นอิสระต่อกัน ซึ่งทำให้มันเป็นตัวเลขแบบระมัดระวัง (conservative) — ค่าตัวคูณ Stop Loss ตัวเดียวกันสิบค่า ไม่ใช่สิบไอเดียที่เป็นอิสระต่อกัน — และมันเป็นเงื่อนไขที่จำเป็น ไม่ใช่เงื่อนไขที่เพียงพอ: แบ็กเทสต์อาจ overfit ได้แม้บนกลุ่มตัวอย่างที่ยาวกว่าขั้นต่ำมาก สิ่งที่มันเป็นคือคำตอบแรกของคำถามที่คนส่วนใหญ่ไม่เคยถามกับบันทึก — มันมาจากการทดลองกี่ครั้ง — และข้อร้องเรียนหลักของผู้เขียนคือ ตัวเลขนี้แทบไม่เคยถูกรายงาน ทั้งในบทความวิชาการและโดยใครก็ตามที่ขายผลลัพธ์ ซึ่งทำให้ประเมินความเสี่ยงของ overfitting จากผลลัพธ์อย่างเดียวไม่ได้
สำหรับเทรดเดอร์ที่ใช้ดุลยพินิจ จำนวนนั้นน้อยและข้อมูลก็สั้น กราฟ 4 ชั่วโมงหนึ่งปีบนสองคู่เงิน กับเซ็ตอัปที่ตัวคูณ Stop Loss ตัวกรองเซสชัน และความลึกของการย่อตัว แต่ละตัวถูกลองสามค่า คือการตั้งค่ายี่สิบเจ็ดแบบบนข้อมูลปีเดียว — เกินเส้นของบทความไปแล้ว บันทึกของผู้ชนะอาจยังดีอยู่ แค่ยังไม่ใช่หลักฐานเท่านั้น
กันข้อมูลไว้
วิธีแก้ที่เก่าที่สุดคือเก็บข้อมูลบางส่วนไว้ให้ห่างจากการปรับแต่ง
การทดสอบนอกกลุ่มตัวอย่าง (out-of-sample test) คือการรันกฎครั้งเดียวโดยไม่เปลี่ยนอะไร บนข้อมูลที่มันไม่เคยถูกปรับแต่ง ถ้าบันทึกนอกกลุ่มตัวอย่างคล้ายกับบันทึกในกลุ่มตัวอย่าง — ค่าคาดหวังในระดับเดียวกัน ช่วงที่ซ้อนทับกัน — กฎได้เรียนรู้สิ่งที่คงอยู่เลยข้อมูลที่ใช้ปรับแต่งไป ถ้าบันทึกพังลง ตัวเลขในกลุ่มตัวอย่างก็คือ noise วินัยทั้งหมดอยู่ในคำว่า ครั้งเดียว: ข้อมูลที่กันไว้ถูกใช้หมดทันทีที่มองมัน และการปรับใด ๆ หลังจากมองแล้ว ทำให้การรันครั้งต่อไปเป็น in-sample ตามนิยาม บทความระบุข้อจำกัดของวิธีนี้ด้วย — ข้อมูลที่กันไว้ไม่รู้ว่ามีการทดลองมาก่อนกี่ครั้ง ดังนั้นกฎที่ผ่านการทดสอบบนข้อมูลที่กันไว้ ก็ยังเป็นแบบที่ดีที่สุดใน N แบบในอีกความหมายหนึ่ง — แต่ในฐานะตัวกรองชั้นแรก มันตัดสิ่งที่หัวข้อก่อนหน้าบรรยายไว้ออกไปได้เกือบหมด
การทดสอบล่วงหน้า (forward test) ของระดับกลางคือแนวคิดเดียวกัน โดยข้อมูลมาจากปฏิทินแทนที่จะมาจากคลังข้อมูลย้อนหลัง: เทรดบนบัญชีทดลองที่ทำแบบเรียลไทม์ไม่อาจถูกใช้ปรับแต่งได้ เพราะตอนนั้นมันยังไม่เกิดขึ้น
เดินหน้า (walk forward)
การแบ่งครั้งเดียวใช้ข้อมูลไปครั้งเดียว การเดินหน้าใช้ข้อมูลซ้ำหลายรอบ และได้บันทึกนอกกลุ่มตัวอย่างที่ยาวกว่าจากข้อมูลย้อนหลังชุดเดิม
การทดสอบแบบ walk-forward คือการทดสอบนอกกลุ่มตัวอย่างที่ทำซ้ำตลอดข้อมูลย้อนหลัง: ปรับแต่งบนช่วงแรก ทดสอบในช่วงถัดจากนั้น เลื่อนทั้งสองไปข้างหน้าเท่ากับความยาวของช่วงทดสอบ แล้วนำช่วงทดสอบมาต่อกัน บันทึกที่ต่อกันแล้วมีคุณสมบัติที่สำคัญ — ไม่มีส่วนใดถูกใช้ปรับแต่ง — และยาวพอที่จะมีแถบความคลาดเคลื่อนของตัวเอง มันยังให้สิ่งที่การแบ่งครั้งเดียวให้ไม่ได้: ลำดับของพารามิเตอร์ที่ถูกเลือกในแต่ละช่วง ถ้าตัวคูณ Stop Loss ที่ทดสอบได้ดีที่สุดคือ 1.5 ในช่วงหนึ่ง 2.5 ในช่วงถัดไป และ 1.2 ในช่วงที่สาม กฎนี้ไม่มีพารามิเตอร์ที่คงที่ และการปรับแต่งใหม่ทุกช่วงก็คือ overfitting ที่ทำตามตารางเวลา
ที่ราบ ไม่ใช่จุดยอด
ด่านป้องกันสุดท้ายว่าด้วยวิธีเลือกพารามิเตอร์ภายในช่วงหนึ่ง และไม่ต้องใช้ข้อมูลที่กันไว้เลย
กวาดค่าพารามิเตอร์ไปตลอดช่วงที่สมเหตุสมผล แล้ววาดผลเทียบกับมัน กฎที่ใช้ได้จะมีที่ราบ: ช่วงของค่าที่ให้ผลใกล้เคียงกัน เพราะลักษณะของตลาดที่กฎจับได้ไม่ไวต่อตัวเลขที่แน่นอน กฎที่เข้ากับ noise จะมีจุดยอด: ค่าเดียวที่ดีกว่าค่าข้างเคียงมาก เพราะค่านั้นบังเอิญจับความบังเอิญของกลุ่มตัวอย่างนี้ได้ จุดยอดเป็นค่าสูงสุดเสมอ ซึ่งเป็นเหตุผลที่การเลือกค่าสูงสุดคือความผิดพลาด เลือกค่าภายในที่ราบ — ตรงกลางของมัน ไม่ใช่จุดที่ดีที่สุดบนนั้น — แล้วกฎจะเสียไปเล็กน้อยบนข้อมูลที่ใช้ปรับแต่ง และรักษาส่วนใหญ่ไว้ได้ในที่อื่น
ประเด็นสำคัญ แบบที่ดีที่สุดใน N การทดลองคาดว่าจะดูดีเพราะความบังเอิญ และดูดีแค่ไหนก็เพิ่มขึ้นตาม N นับการทดลองและเก็บจำนวนนั้นไว้คู่กับบันทึก กันข้อมูลไว้และใช้มันครั้งเดียว ทดสอบแบบเดินหน้า และอ่านลำดับพารามิเตอร์ควบคู่กับบันทึกที่ต่อกันแล้ว ภายในช่วงหนึ่ง เลือกที่ราบ ไม่ใช่จุดยอด
บันทึกการทดลอง
ทุกอย่างข้างต้นลดลงเหลือการเพิ่มสิ่งเดียวในบันทึกการเทรด (trading journal) ที่คอร์สจิตวิทยาการเทรดสร้างไว้: บันทึกการทดลอง ทุกการตั้งค่าที่ลอง ข้อมูลที่ใช้ลอง ผลของมัน และเหตุผลที่ทิ้ง — รวมถึงแบบที่ลองแค่ในหัวช่วงบ่ายหนึ่งแล้วเลิกไป เพราะประเด็นของบทความคือแบบเหล่านั้นก็นับด้วย บันทึกนี้ทำสามอย่าง มันให้ค่า N เพื่อให้อ่านตัวเลขของผู้รอดเทียบกับจำนวนผู้แพ้ได้ มันบันทึกการกวาดค่าพารามิเตอร์ เพื่อให้แยกจุดยอดออกจากที่ราบได้ในภายหลัง เมื่อกลุ่มตัวอย่างยาวขึ้น และมันทำให้การปรับแต่งปรากฏในฐานะการปรับแต่ง ซึ่งเป็นการป้องกันเพียงอย่างเดียวต่อความรู้สึกจากข้างในว่าการปรับแต่ละครั้งคือการเรียนรู้
ข้อสังเกตสุดท้ายของบทความคือข้อที่ควรใช้ปิดท้าย เมื่อไม่ได้นับการทดลอง แบ็กเทสต์ที่ดีไม่ได้แค่ไม่ให้ข้อมูล บนข้อมูลที่มีความจำ — ที่ช่วงเวลาที่ถูกปรับให้เข้ามักตามมาด้วยสิ่งตรงข้าม — ผู้เขียนแสดงว่าค่าคาดหวังนอกกลุ่มตัวอย่างของกฎที่ overfit เป็นลบ คำเตือนตามธรรมเนียมที่ว่าผลการดำเนินงานในอดีตไม่ได้บ่งชี้ผลในอนาคต ผู้เขียนกล่าวว่ายังมองโลกในแง่ดีเกินไปในสภาพเช่นนั้น บันทึกที่ถูกคัดเลือกมาไม่ใช่สัญญาณที่อ่อน มันอาจเป็นสัญญาณที่ชี้ไปผิดทาง
บันทึกอยู่ตรงไหนหลังจากนี้
กลุ่มนี้จบแล้ว ตอนนี้บันทึกหนึ่งชุดมีสามสิ่งที่ยังไม่มีเมื่อจบระดับกลาง: แถบความคลาดเคลื่อนของค่าคาดหวัง การกระจายรอบ Drawdown (การลดลงของพอร์ต) และจำนวนการทดลองเบื้องหลัง เซ็ตอัปที่ช่วงความเชื่อมั่นพ้นต้นทุน ที่หางของ Drawdown ถูกนำมาคิดในการกำหนดขนาดแล้ว และที่จำนวนการทดลองน้อยและถูกจดไว้ มี edge ในความหมายเดียวที่ระดับนี้ใช้คำนี้ กลุ่มสุดท้ายของระดับนี้ — ตอนที่ 14 ถึง 16 — นำเซ็ตอัปที่ผ่านแล้วมาเปลี่ยนเป็นสิ่งที่เดินได้: ตารางการตัดสินใจ กฎการแจ้งเตือนและการส่งคำสั่ง และรอบการทบทวนพร้อมเกณฑ์สำหรับปิดมัน
ถัดไป: จากกฎสู่ตารางการตัดสินใจ — ทุกสถานะของตลาดได้คอลัมน์ของตัวเอง และช่องโหว่กับความขัดแย้งที่ร้อยแก้วซ่อนไว้ก็ปรากฏออกมา
- ในการตั้งค่า 10 แบบที่มี Sharpe ratio จริงเป็นศูนย์ แบบที่ดีที่สุดคาดว่าจะแสดง Sharpe ratio ในกลุ่มตัวอย่าง 1.57 (Bailey, Borwein, López de Prado และ Zhu, 2014)
- ด้วยข้อมูล 5 ปี ไม่ควรลองการตั้งค่าที่เป็นอิสระต่อกันเกิน 45 แบบ ก่อนที่จะคาดได้ว่าแบบที่ไม่มีฝีมือจะทำ Sharpe ratio ในกลุ่มตัวอย่างได้ถึง 1 ถ้ามีข้อมูล 2 ปี ตัวเลขนี้คือ 7
- จำนวนการทดลองเบื้องหลังแบ็กเทสต์แทบไม่เคยถูกรายงาน ทำให้ประเมินความเสี่ยงของ overfitting จากผลลัพธ์อย่างเดียวไม่ได้
- ผลนอกกลุ่มตัวอย่างของกฎที่ overfit คาดว่าจะอยู่ราวศูนย์ถ้าอนุกรมไม่มีความจำ และติดลบถ้ามี
- การทดสอบนอกกลุ่มตัวอย่าง (out-of-sample) กันข้อมูลที่กฎไม่เคยถูกปรับแต่งไว้ การทดสอบแบบ walk-forward ทำการแบ่งแบบนั้นซ้ำทีละช่วงตลอดข้อมูลย้อนหลัง